Embeddingy 101: Jak funguje vyhledávání podle významu, nikoli slov
Embeddingy převádějí text na vektory, které zachycují jeho význam. Pomocí nich dokážeme vyhledávat relevantní paragrafy v zákonech i bez přesných slov. Tento přístup přináší přesnější a intuitivnější vyhledávání.

Denis Čapkovič
CEO a spoluzakladatelPopis embeddingů je poměrně jednoduchý. Libovolnému textu dokážeme přiřadit „číslo“, které reprezentuje jeho význam. Pojďme si říct, jak to ve skutečnosti funguje a jaké to má důsledky pro vyhledávání.
Přiznávám, že když jsem zmínil „číslo“, šlo pouze o zjednodušení a není to úplně pravda. Embeddingy se reprezentují pomocí vektorů. Vektory jsou šipky, které mají směr a délku.
Protože embeddingy reprezentujeme pomocí vektorů, můžeme s nimi provádět operace. Pro nás jde především o sčítání, odčítání a porovnávání polohy.
Dokážeme tedy určit, jak blízko jsou si dva vektory. Nebo můžeme vzít jeden vektor, odečíst od něj druhý a jako výsledek získat nový vektor.
Tímto končí matematické okénko a přecházíme k příkladům.
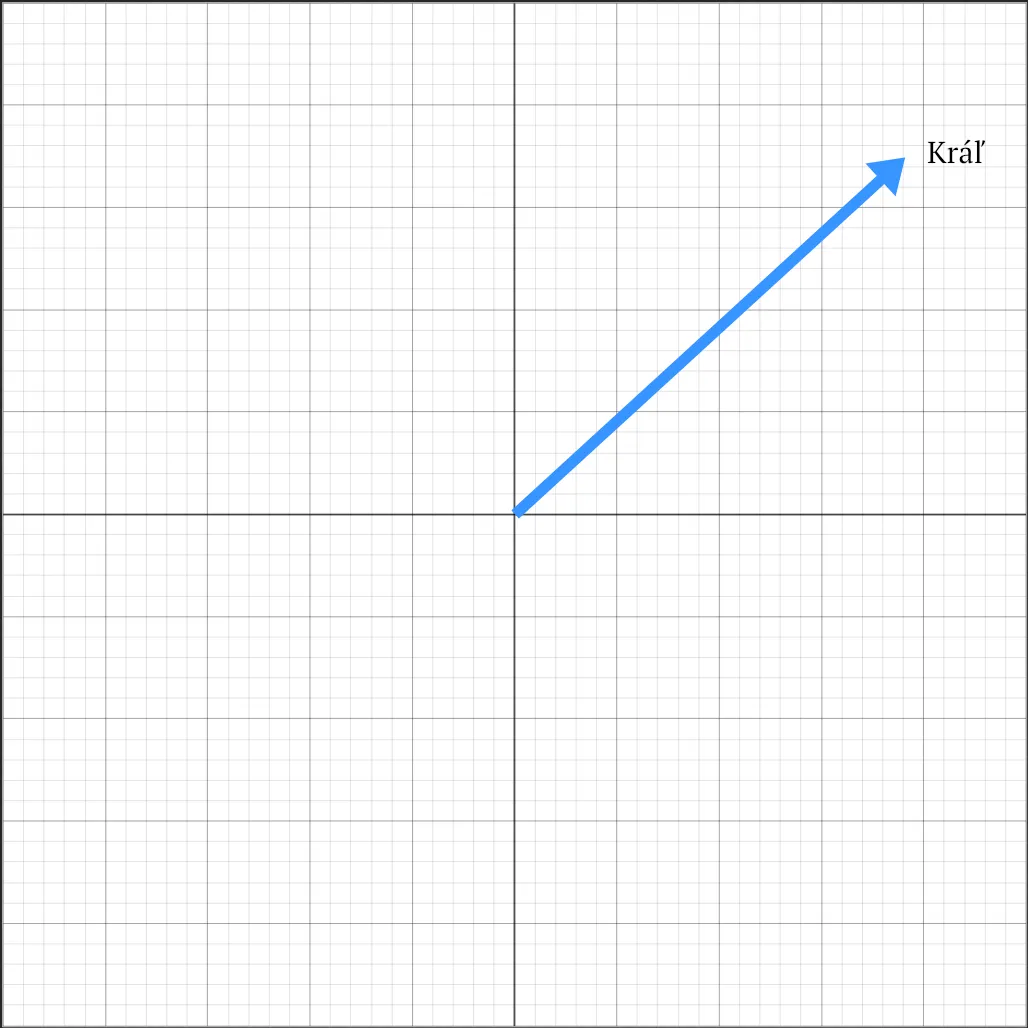
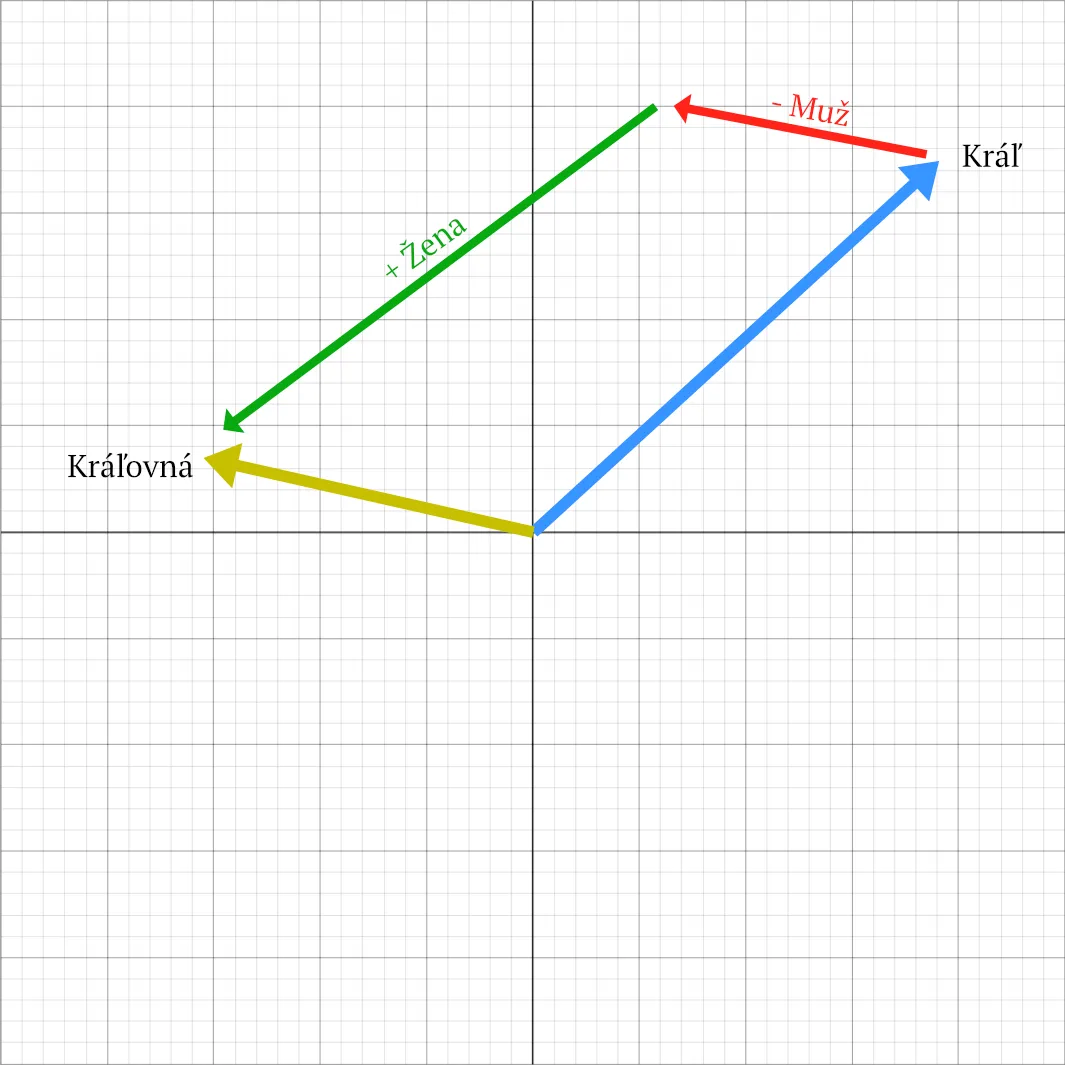
Vektor, který vidíme, reprezentuje slovo „Král“ – jeho význam v každém směru, jak jej chápeme. Král je muž, který sedí na trůnu, figurka v šachu, karta v pokeru atd. Všechny tyto významy reprezentuje šipka, kterou vidíte na obrázku.
Přidejme další šipku, která reprezentuje slovo „Královna“, rovněž ve všech jeho významech.
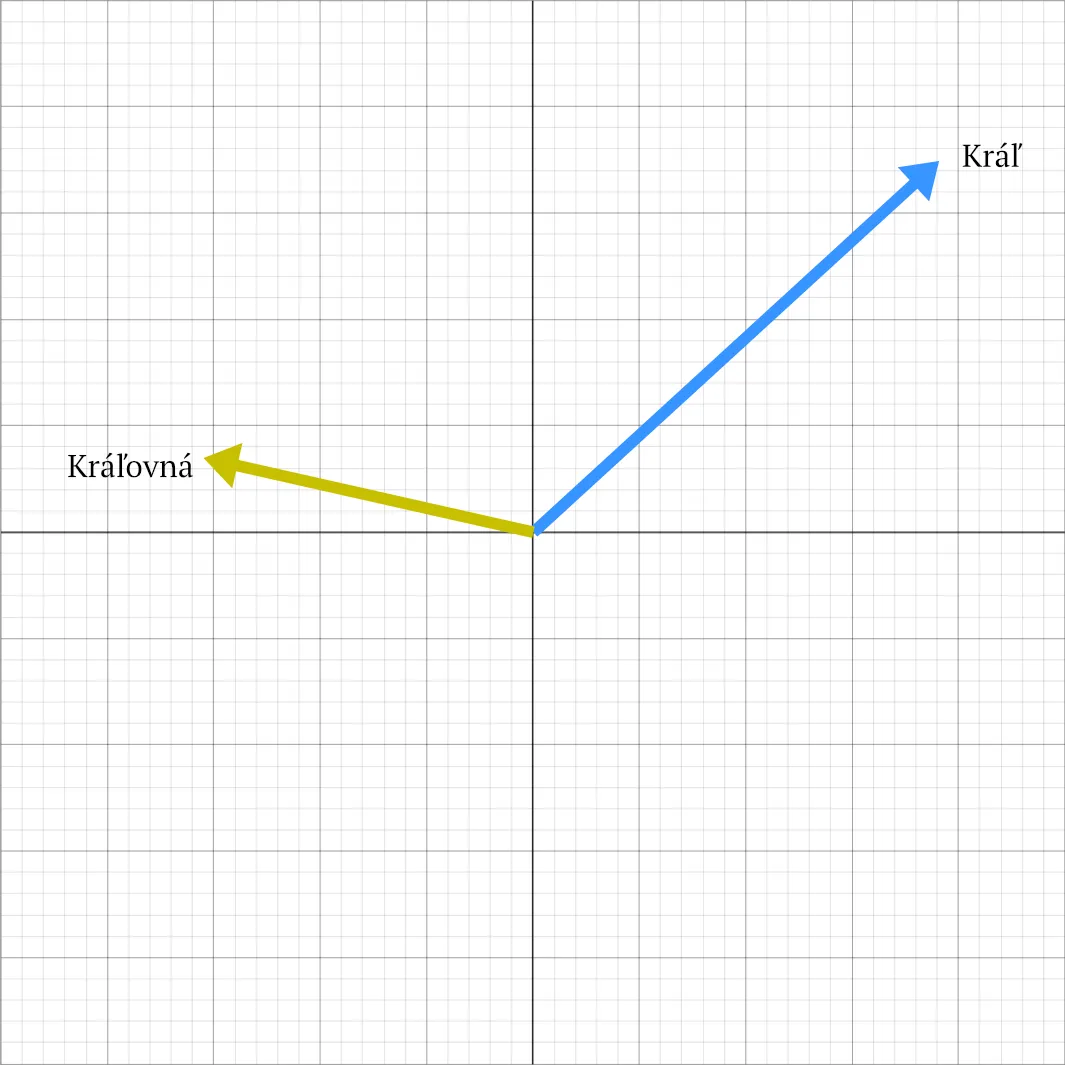
A protože dokážeme provádět matematické operace s vektory, můžeme vyzkoušet, co se stane, když budeme odečítat a přičítat koncepty. Když od slova „Král“ odečteme „Muž“ a přičteme „Žena“, dostaneme „Královna“. Tento princip funguje u všech slov a zachycuje překvapivě mnoho vztahů, které si běžně ani neuvědomujeme.
Mým oblíbeným příkladem je, že když vezmeme „mňau“, odečteme „kočka“ a přičteme „Santa“, dostaneme „ho ho ho“.
Můžeme také vzít šipku pro slovo „pes“ a zjistit, které podobné šipky (slova) jsou mu nejblíže. Pro „pes“ to budou například „psi“, „pejsek“, „domácí mazlíček“, „buldok“ atd. Stejným způsobem můžeme vzít dvě slova a určit, jak daleko jsou od sebe, respektive nakolik jsou si podobná. Čím blíže jsou, tím jsou si podobnější. Například „kočka“ a „pes“ jsou si mnohem blíže než „kočka“ a „auto“.
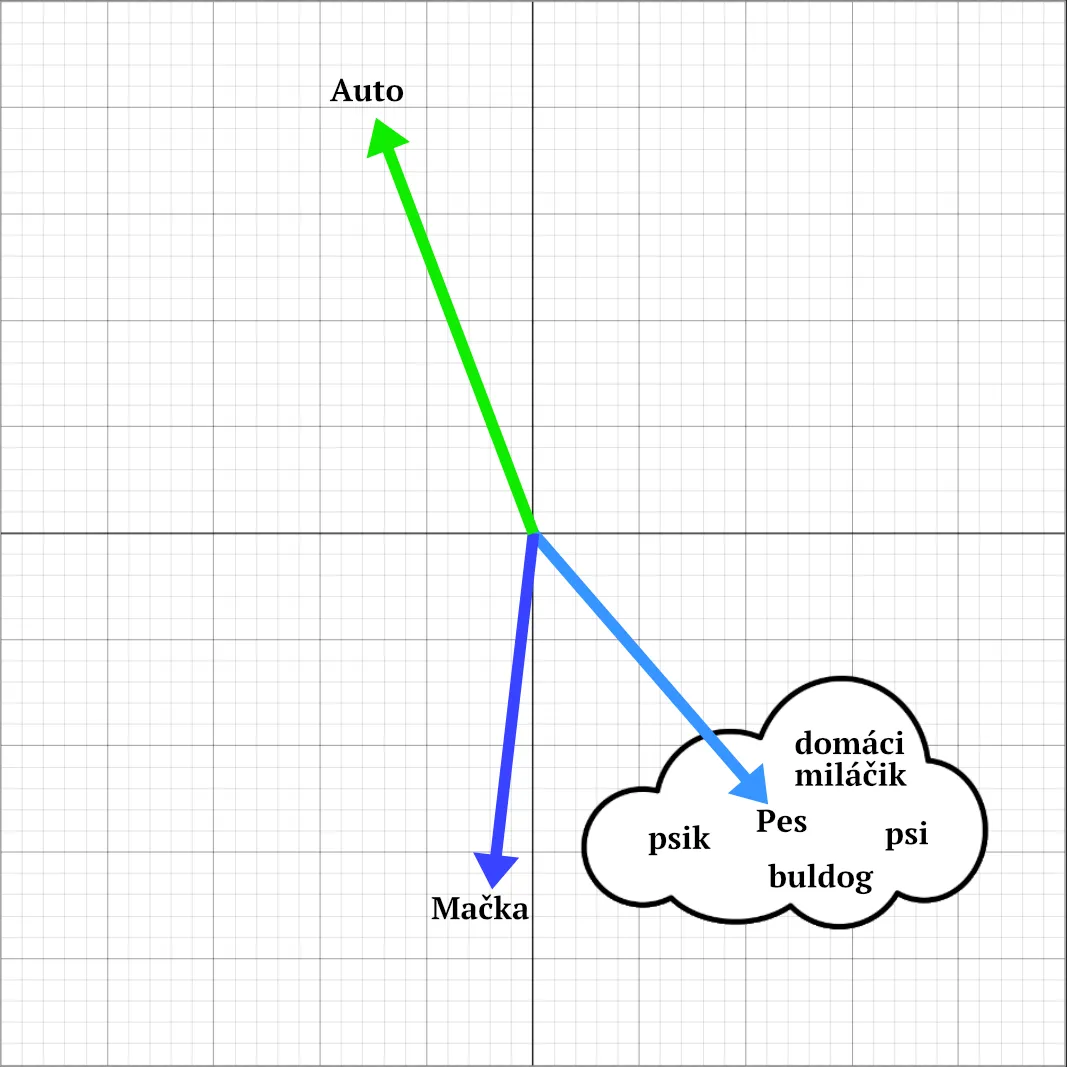
Nedokážeme přesně říct, zda jsou slova totožná, ale můžeme určit, jak blízko či daleko jsou od sebe na škále od 0 do 1. Čím je číslo menší, tím blíže si slova jsou a můžeme říct, že jsou významově podobná, respektive že reprezentují podobný koncept.
V našem konkrétním příkladu to funguje tak, že vezmeme celý paragraf a vytvoříme z něj vektor. Tento vektor následně uložíme. Stejný proces provedeme pro všechny paragrafy a texty ve všech zákonech. Když pak uživatel něco vyhledává, vytvoříme vektor z jeho dotazu a podíváme se, které vektory jsou mu nejblíže. Pokud například zadáme vyhledávání „balkon jako společná část domu“, jako nejbližší text najdeme odstavce (1 a 3) § 10 zákona číslo 182/1993.
Je však třeba poznamenat – jak bylo vidět na příkladu s králem –, že význam je zaznamenán v několika smyslech. To znamená, že pro praktické využití je třeba používat více filtrování, ale i tak získáváme velmi relevantní výsledky.
Ještě několik poznámek na závěr:
- Je třeba si uvědomit, že postup převodu textu na vektor závisí na embeddingovém modelu, který používáme. Každý model tedy poskytne jiný výsledek.
- V příkladech jsme pro jednoduché znázornění principu používali 2D vektory. V praxi však nelze každé slovo přesně lokalizovat v takto jednoduchém prostoru. Proto se používají mnohem větší vektory (s více dimenzemi). Například u modelů OpenAI jde konkrétně o 3072 dimenzí.
- V textu jsme zmínili, že vytvoříme embedding z paragrafu. To však není vždy možné, pokud je paragraf příliš dlouhý – tehdy je nutné jej před embedováním správně rozdělit a zároveň upravit způsob vyhledávání, abychom dosáhli správných výsledků.
- Je také třeba dávat pozor, pokud se na začátku dokumentu nacházejí důležité informace o jeho významu. Je nutné zajistit, aby se tyto informace „přenesly“ také do textů na konci dokumentu. Jinak bychom při vyhledávání některé odstavce vůbec nenašli, protože informace ze začátku dokumentu by se ve vektoru nenacházely.
- A mnohem více…
Doufám, že jsem vám poskytl dobrý přehled o embedinzích a jejich využití.
Pokud máte otázky, klidně mi napište – rád odpovím. A pokud si chcete embeddingy vyzkoušet v praxi, navštivte app.praktik.ai.